
Ein Chatbot kann heute erstaunlich gut mit unvollständigen Anweisungen umgehen. „Plane mir einen schönen Samstag in Hamburg“ reicht, und wenige Sekunden später stehen Hafen, Speicherstadt, ein Restaurant und vielleicht die Elbphilharmonie auf dem Bildschirm. Für eine erste Idee ist das praktisch. Für eine echte Planung fehlen trotzdem fast alle Informationen, die darüber entscheiden, ob der Tag für dich gut ist.
Vielleicht warst du schon dreimal in Hamburg. Vielleicht reist ein Kind mit. Vielleicht willst du gerade nicht die bekannten Sehenswürdigkeiten sehen. Vielleicht soll alles zu Fuß erreichbar sein, oder der Samstag ist nur ein Zwischenstopp zwischen zwei Zugverbindungen. Das Modell kennt diese Randbedingungen nicht. Es macht deshalb das, was Sprachmodelle gut können: Es ergänzt plausible Annahmen.
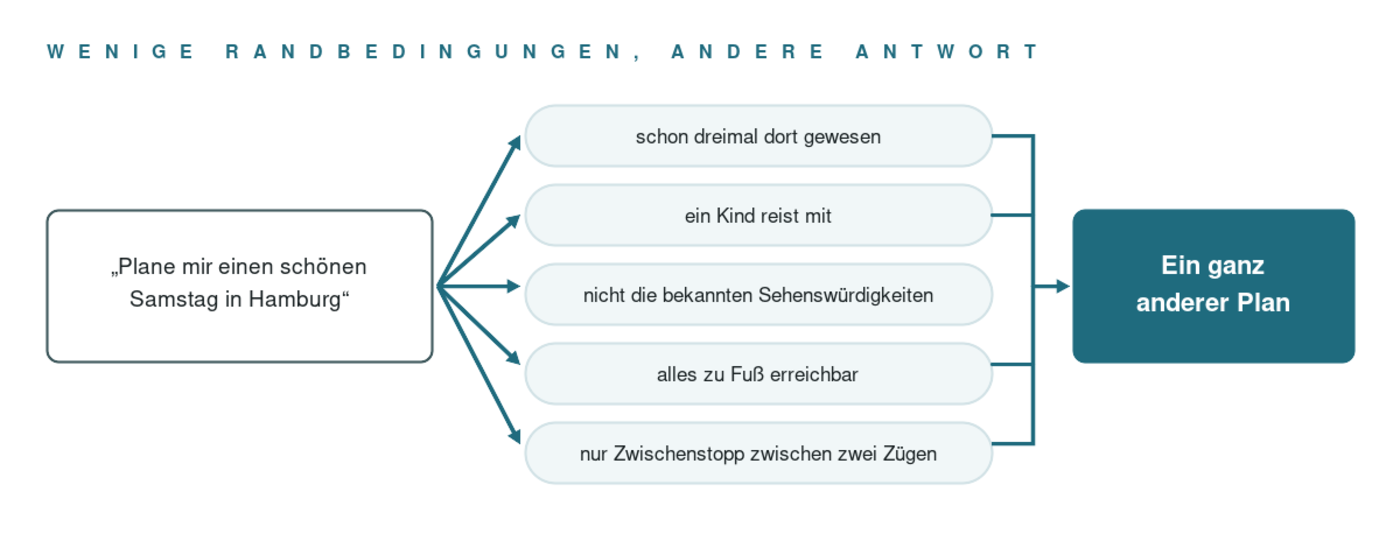
Genau darin liegt die Stärke und die Schwachstelle eines Chatbots. Er zwingt dich nicht, eine Aufgabe vollständig zu spezifizieren. Das macht die Nutzung angenehm. Gleichzeitig kann eine Antwort sehr ordentlich aussehen, obwohl sie ein anderes Problem löst als das, das du im Kopf hattest.
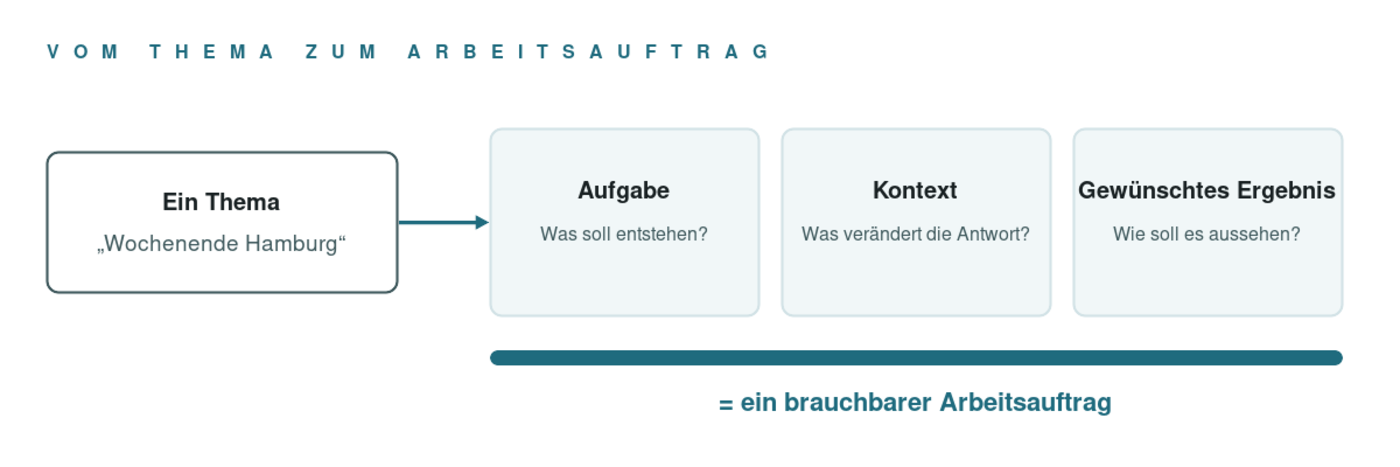
Der erste Schritt zu besserer KI-Nutzung besteht daher nicht in einem komplizierten Prompt-Verfahren. Es reicht, drei Dinge auseinanderzuhalten: die Aufgabe, den relevanten Kontext und das gewünschte Ergebnis.
Ein Thema ist noch keine Aufgabe
Eine Eingabe wie
Wochenende Hamburgist ein Thema. Ein Modell kann damit etwas anfangen, muss aber selbst entscheiden, welche Art von Antwort gemeint ist. Es könnte Sehenswürdigkeiten nennen, einen Reiseplan entwerfen, Hotels empfehlen oder erklären, wann sich ein Besuch besonders lohnt.
Eine kleine Ergänzung macht daraus eine Aufgabe:
Plane einen Samstag in Hamburg für zwei Erwachsene.
Wir sind zum ersten Mal dort und wollen die wichtigsten Orte sehen,
ohne den ganzen Tag von Termin zu Termin zu hetzen.
Noch genauer wird es, wenn die Randbedingungen wirklich relevant sind:
Plane einen Samstag in Hamburg für zwei Erwachsene.
Wir kommen um 9:30 Uhr am Hauptbahnhof an und fahren um 20:00 Uhr wieder ab.
Wir wollen viel zu Fuß machen, maximal einmal den Nahverkehr benutzen
und keine Museen besuchen.

Gib zuerst nur eine Route mit 5 bis 7 Stationen aus.
Restaurants suchen wir danach.
Der dritte Prompt ist nicht besser, weil er länger ist. Er ist besser, weil er Entscheidungen enthält, die das Ergebnis sichtbar verändern. Ankunft und Abfahrt begrenzen die Zeit. „Viel zu Fuß“ beeinflusst die Route. „Keine Museen“ schließt eine ganze Klasse naheliegender Vorschläge aus. Und die Vorgabe, zuerst nur die Route zu planen, verhindert, dass das Modell bereits Restaurantdetails ausarbeitet, bevor feststeht, in welchem Viertel ihr überhaupt seid.
Das ist ein Muster, das bei sehr unterschiedlichen Aufgaben funktioniert. Eine Präsentation über ein Projekt wird brauchbarer, wenn Zielgruppe und Zweck genannt werden. Eine Kaufberatung verbessert sich, wenn Budget und wichtige Kriterien klar sind. Eine Zusammenfassung wird besser, wenn feststeht, ob sie nur einen schnellen Überblick liefern oder eine Entscheidung vorbereiten soll.
Der gemeinsame Punkt ist einfach: Das Modell braucht nicht nur ein Thema, sondern eine Handlung.
Kontext ist das, was die Antwort verändert
Nach den ersten Erfolgen mit besseren Prompts passiert häufig das Gegenteil. Aus zu wenig Kontext wird zu viel Kontext. Der komplette Mailverlauf wird eingefügt, dazu drei Dokumente, eine alte Präsentation und ein paar Notizen, die „vielleicht noch wichtig“ sein könnten. Moderne Modelle können damit umgehen, aber die zusätzliche Information ist nicht automatisch ein Vorteil.
Ein brauchbarer Test prüft, ob eine andere Ausprägung dieser Information eine gute Antwort tatsächlich verändern würde.
Bei der Hamburg-Planung ist die Abfahrtszeit relevant. Eine Rückfahrt um 14 Uhr erzeugt einen anderen Tag als eine Rückfahrt um 20 Uhr. Die Information, welche Farbe dein Koffer hat, verändert die Route nicht. Sie gehört also nicht in den Prompt.
Diese Definition ist absichtlich praktischer als „gib dem Modell möglichst viel Hintergrund“. Hintergrund ist nur dann nützlich, wenn er eine Entscheidung verbessert. Alles andere ist Material, das das Modell ebenfalls einordnen muss.
Später wird diese Unterscheidung noch wichtiger. Bei der Bearbeitung größerer Projekte stehen oft viele Dateien, frühere Chats und gespeicherte Informationen zur Verfügung. Dann entsteht das Auswahlproblem, welche davon für den aktuellen Schritt wirklich gebraucht werden. Wer diese Frage schon beim einfachen Chat versteht, hat später mit Projekten und Agenten deutlich weniger Chaos.
Beschreibe das Ergebnis, nicht nur die Arbeit
Viele Prompts sagen, was das Modell tun soll, aber nicht, wie das Ergebnis gebraucht wird. „Fasse diesen Text zusammen“ ist eine klare Aufgabe. Trotzdem kann eine Zusammenfassung in fünf Sätzen, als Stichpunktliste oder als halbe Seite Fließtext sinnvoll sein.
Wenn du nur schnell wissen möchtest, worum es geht, reicht vielleicht:
Fasse den Text in höchstens sechs Sätzen zusammen.
Ich will nur Thema, wichtigste Aussage und Ergebnis verstehen.
Wenn die Zusammenfassung eine Entscheidung vorbereitet, verschiebt sich der Auftrag:
Fasse den Text für eine Entscheidungsvorlage zusammen.

Nenne:
- die wichtigsten Aussagen,
- alle Zahlen, die für die Entscheidung relevant sind,
- die stärksten Gegenargumente,
- offene Punkte, die der Text nicht klärt.

Maximal 500 Wörter.
Dasselbe Ausgangsmaterial kann dadurch zu einer deutlich anderen Ausgabe führen. Das Modell erhält keine geheimen Zusatzfähigkeiten. Es kennt nur besser den Zweck.
Für viele Alltagsaufgaben reicht deshalb ein kleines Grundmuster:
Aufgabe:
Was soll erledigt werden?

Kontext:
Welche Informationen verändern eine gute Antwort?

Ergebnis:
Wie soll die Ausgabe aussehen, damit ich sie verwenden kann?
Das ist kein Formular, das vor jedem Prompt ausgefüllt werden muss. Eine Übersetzung braucht selten drei Überschriften. Bei schwierigeren Aufgaben hilft das Schema aber, fehlende Informationen sichtbar zu machen.
Rollen nur dann, wenn sie etwas verändern
Rollen können eine relevante Perspektive vorgeben. Bei einer Präsentation ist etwa „Prüfe die Gliederung aus Sicht einer Bereichsleitung, die vor allem Entscheidung, Risiko und Blockaden verstehen muss“ sinnvoll, weil diese Perspektive die Auswahl der Informationen verändert.
Lange Personas wie „Du bist ein weltweit führender Experte mit 30 Jahren Erfahrung“ liefern dagegen selten zusätzliche Daten oder Kriterien. Ein einfacher Test genügt: Welche konkrete Entscheidung soll die Rolle verändern? Gibt es darauf keine Antwort, kann sie meistens weg.
Die KI darf nachfragen
Viele Nutzer versuchen, einen Prompt vor dem Abschicken vollständig zu machen. Das ist bei einfachen Aufgaben kein Problem. Bei offenen Aufgaben führt es schnell zu langen Anweisungen, obwohl der Chatbot selbst beim Klären helfen kann.
Angenommen, du willst einen neuen Laptop kaufen und weißt noch nicht, welche technischen Kriterien wirklich wichtig sind. Statt zuerst eine halbe Stunde Anforderungen zu sammeln, kann der Auftrag so beginnen:
Ich möchte einen neuen Laptop kaufen.
Stell mir zuerst höchstens sechs Fragen, die meine Auswahl wirklich verändern.
Mach noch keine Empfehlung.
Die Antworten liefern danach den Kontext für den eigentlichen Vergleich.
Dasselbe funktioniert bei einer Präsentation:
Ich muss in zehn Minuten den Stand eines Projekts vorstellen.
Frag mich zuerst nach den Informationen, die du für eine gute Gliederung brauchst.
Beginne noch nicht mit den Folien.
Der Chatbot wird damit vom Antwortautomaten zum Sparringspartner für die Aufgabenklärung. Das ist besonders hilfreich, wenn du den Fachinhalt kennst, aber noch nicht weißt, welche Informationen für eine gute Ausgabe fehlen.
Rückfragen sollte man trotzdem nicht zum Selbstzweck machen. Wenn eine Kleinigkeit kaum Einfluss auf das Ergebnis hat, darf das Modell eine vernünftige Annahme treffen und sie kenntlich machen. Sonst wird aus jeder einfachen Aufgabe ein Interview.
Eine brauchbare Formulierung für schwierigere Fälle ist:
Wenn eine fehlende Information das Ergebnis wesentlich verändern würde,
frage zuerst nach. Kleinere Unklarheiten darfst du als Annahme kennzeichnen.
Damit bekommt das Modell ein Kriterium statt einer pauschalen Pflicht zum Nachfragen.
Iteration ist normal
Ein guter erster Prompt muss nicht alle Details vorwegnehmen. Eine erste Antwort zeigt oft, welche Randbedingung noch fehlt. Statt den gesamten Auftrag neu zu schreiben, benennt man die Abweichung.
Aus „Mach es besser“ wird beispielsweise: „Die Gliederung passt. Es fehlt aber der Entscheidungsbedarf. Vergleiche Variante A und B nach Aufwand, Terminrisiko und Kundenauswirkung; die letzte Folie soll eine Entscheidungsvorlage sein.“
Das Muster bleibt über das ganze Buch gleich: Entwurf erzeugen, Abweichung beobachten, gezielt korrigieren. Später werden aus dieser menschlichen Rückmeldung Tests, Quellenprüfungen, Änderungsvergleiche oder Abnahmekriterien.
Wann ein kurzer Prompt besser ist
Viele Aufgaben sind bereits eindeutig. „Übersetze diesen Absatz ins Englische“ oder „Gib mir fünf sachliche Titel“ brauchen weder Rollen noch ein Schema mit sechs Überschriften.
Zusätzliche Struktur lohnt sich erst, wenn sie eine echte Unbestimmtheit beseitigt: fehlender Kontext, mehrere mögliche Zielgruppen, harte Randbedingungen oder ein Ergebnisformat, das weiterverarbeitet werden soll. Prompt-Länge ist deshalb kein Qualitätsmaß.
Prüfen, was geprüft werden kann
Eine gut formulierte Antwort ist noch keine richtige Antwort. Wie viel Prüfung nötig ist, hängt von der Aufgabe ab.
Bei einem Reiseplan prüfst du Öffnungszeiten und Verbindungen, wenn sie für den Tag wichtig sind. Bei einer Textüberarbeitung entscheidest du selbst, ob Ton und Inhalt passen. Eine Rechnung lässt sich mit einem Rechner kontrollieren. Aktuelle Produktinformationen sollten aus einer aktuellen Quelle stammen. Bei einer langen Zusammenfassung lohnt sich ein Blick darauf, ob wichtige Aussagen des Originals erhalten geblieben sind.
Ein hilfreiches Prinzip lautet: Verwende für die Prüfung das einfachste verlässliche Werkzeug. Wenn eine Zahl mit einem Rechner kontrolliert werden kann, braucht man kein zweites Sprachmodell. Wenn ein Datum in einer offiziellen Fahrplanauskunft steht, ist diese Quelle besser als die Erinnerung eines Modells.
Mit wachsender Delegation wird dieses Prinzip wichtiger. Ein Coding Agent sollte Code nicht nur schreiben, sondern Tests ausführen. Ein Agent mit Dateizugriff sollte Änderungen nachvollziehbar machen. Die Prüfung wandert damit schrittweise aus dem Bauchgefühl in den Arbeitsablauf.
Ein kleiner Praxistest
Nimm drei bis fünf reale Aufgaben aus deiner eigenen Nutzung, bei denen die erste Antwort Nacharbeit brauchte. Formuliere sie noch einmal und ergänze nur Informationen, die das Ergebnis tatsächlich verändern. Vergleiche anschließend Zwecktreue, Fehler und nötige Nacharbeit – nicht Länge oder sprachlichen Eindruck.
Diese kleine Fallsammlung wird später wiederverwendet. Als Faustregel reichen drei bis fünf Fälle für einen einzelnen Prompt oder eine Vorlage, fünf bis zehn für einen dauerhaft konfigurierten Spezialisten und zehn bis zwanzig für einen Modellvergleich oder einen wichtigen automatisierten Ablauf. Die Zahlen sind keine Statistikmagie; sie verhindern lediglich, dass eine Entscheidung auf einem einzigen glücklichen Beispiel beruht.
Dieser Text ist Kapitel 1 aus dem Buch „KI Power User“ von Christian Blab (2026). Hier findest du das Buch.